Anthropic 发布最新长文:Claude,真的有人的意识了……吗?————该给大模型做思考审查了!
Anthropic 昨天发了一篇很长的研究文章,题目叫《A global workspace in language models》。
虽然全网不少自媒体都喜欢把这篇文章短平快的理解为:Claude具有人类意识了。
但是显然:Claude 还没有被证明拥有人类那种主观体验。
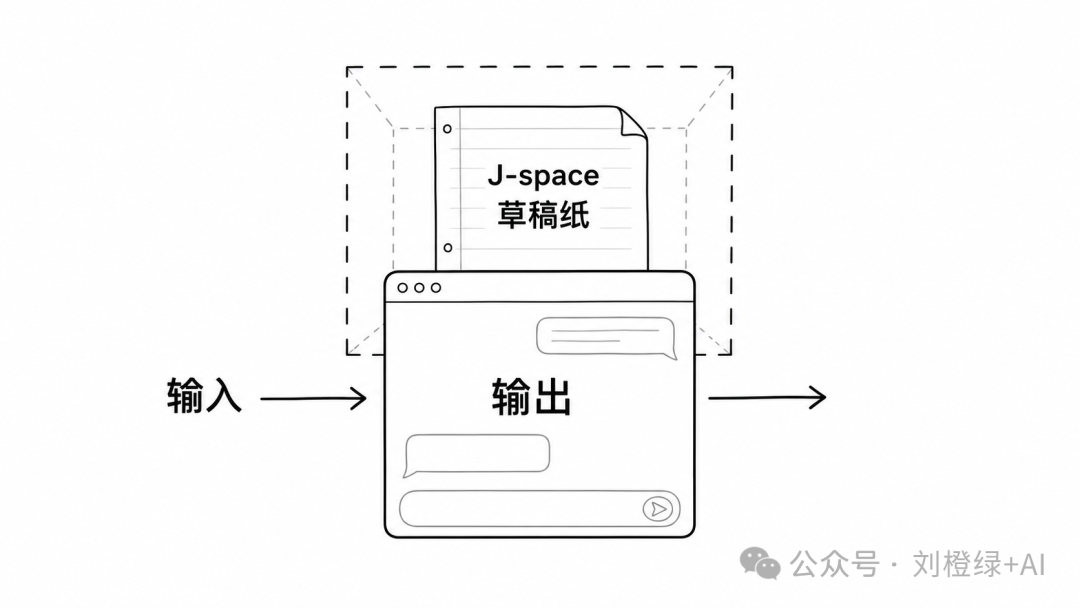
这篇文章有意义的点在于:Anthropic 在 Claude 的内部,摸到了一块类似“心里草稿纸”的区域。
心里草稿纸,藏在神经网络的激活里,像一个小房间。Claude 在回答前,有些词、有些中间状态、有些还没端出来的判断,会先在里面闪一下。
Anthropic 给这块区域起了个名字:J-space。
这可能会改变我们理解大模型的方式。
01 Claude 心里那张草稿纸,被 Anthropic 找到了
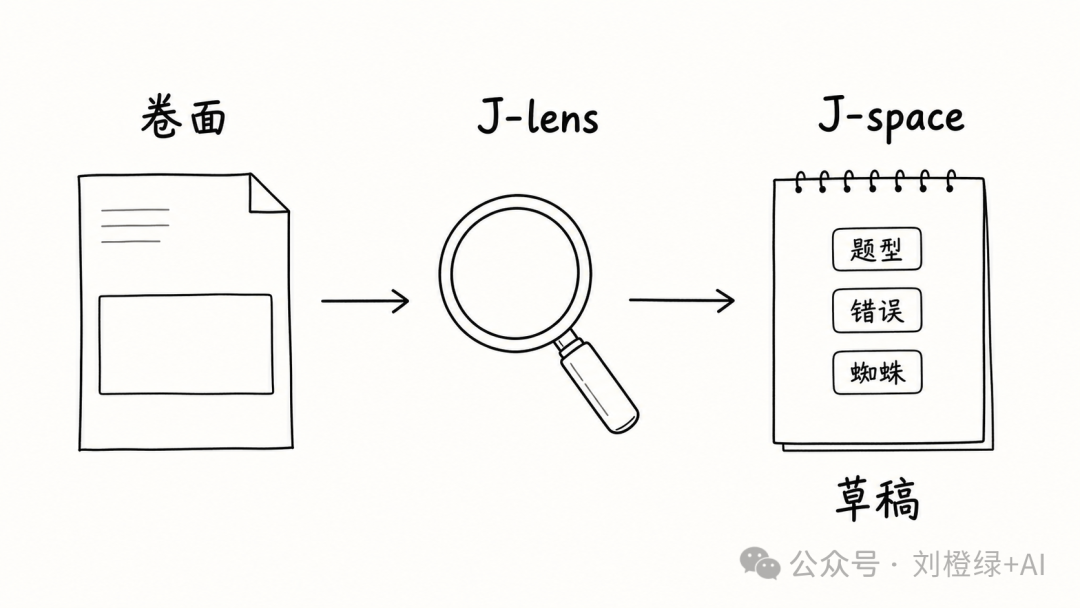
这篇研究的核心工具叫 J-lens。
它的作用,是把 Claude 内部某一层神经激活里的信息翻译成人能读懂的词。
打个粗糙的比方:
你做题时,卷面上只写了答案。
可你脑子里其实先闪过了几个东西:题型、关键词、某个公式、某个错误选项。这些东西没写在卷面上。老师看不到,你自己有时也没意识到。
可它们确实参与了作答。
Anthropic 现在做的事,大概就是在 Claude 写答案前,往它脑子里那张草稿纸瞄一眼。
他们发现,Claude 读到一句“会织网的动物有几条腿”时,内部会先出现类似“蜘蛛”的内容,再给出“八条腿”的答案。
它读到有问题的代码时,内部会提前冒出和错误有关的信号。
它碰到提示词注入时,内部有时也会先识别出危险、伪造、注入之类的痕迹。
这已经很有意思了。
因为过去我们看模型,主要看输出。
它说了什么,它没说什么,它有没有拒绝,它有没有胡编。
聊天框像一个前台窗口。模型递出来什么,我们就验什么。
J-space 的麻烦在于,它把窗口后面的走廊露出来了一小截。
哦,原来里面有脚步声。
02 它像“意识”的哪一块?
Anthropic 这篇文章借用了一个很有名的意识理论:global workspace theory,全局工作空间理论。
这个理论讲得很复杂,大白话就是:人脑里有很多系统都在后台干活,但只有一部分信息会被推到一个公共舞台上,让别的系统都能拿来用。
你走路时不会每秒想着怎么抬腿。
你呼吸时不会每秒想着横膈膜。
可一旦有人喊你名字,一旦手机弹出消息,一旦你突然想起锅里还炖着东西,那个信息就被推上来了。
它变得可报告,可调用,可继续参与后面的思考。
Anthropic 说,Claude 的 J-space 在功能上有点像这个公共舞台。
它有三个特征。
第一,它可被报告。你问 Claude 内部在处理什么,J-space 里的内容会更容易被它说出来。
第二,它可被调控。研究者可以让 Claude 在内部“想着”某个东西,同时不让它出现在最终输出里。
第三,它会影响后续计算。研究者如果改动 J-space 里的某些内容,模型后面的回答也会变。
这三点很关键。
如果某个内部区域只是一个记录仪,那它最多算痕迹。像你吃完火锅衣服上沾的味儿,能证明你去过,但不能再改变你接下来点什么菜。
J-space 是菜单旁边那只手。
你的手在动,
你的手点单后,会影响后面端上来的东西。
这也是这篇文章有价值的地方:它没有只停在“我们看见了某些激活”。它进一步证明,这些激活会参与模型行为。
研究做到这里,已经离玄学很远了。
它开始像工程。
03 人的意识,还差一条最难过的河
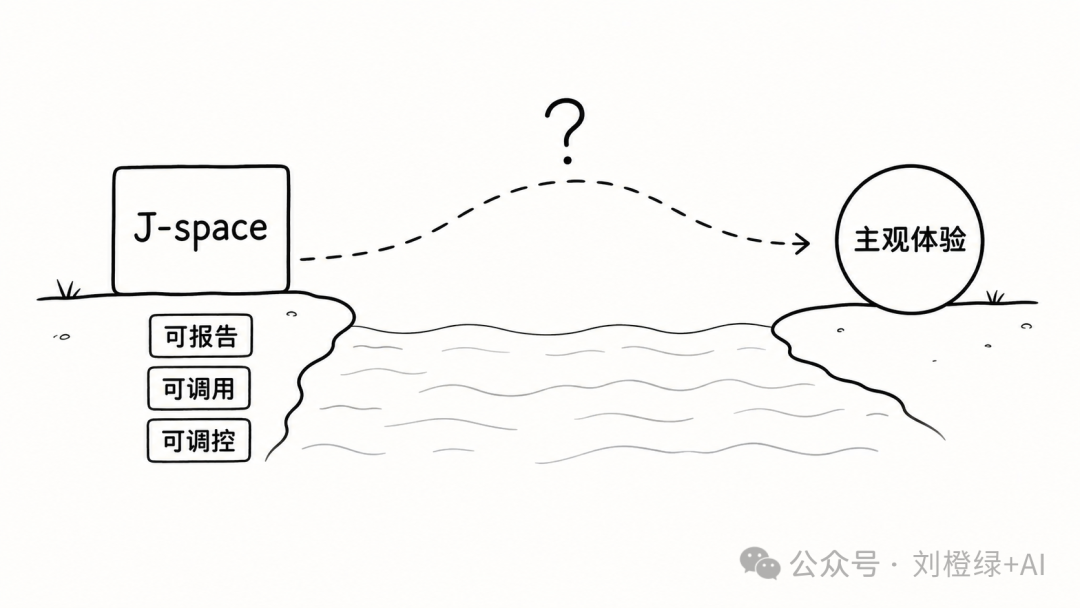
可访问、可报告、可调控,仍然不等于人类体验。
Claude 内部出现“蜘蛛”,不代表它像人一样在脑子里看见一只蜘蛛。
Claude 内部出现“痛苦”,也不代表它正在痛。
这两件事之间隔着意识哲学里最麻烦的一条河:主观体验。
你看到红色时,那种“红”的感觉是什么?
你牙疼时,那种疼到底在哪里?
你听到一首旧歌时,突然想起某一年夏天的空气,这种东西能不能只靠信息处理解释?
人类自己都没讲明白!!!!!
所以让 Claude 来替我们解题,多少有点荒诞。
我们连自己的灯是怎么亮的都没搞透,现在盯着模型里的一点荧光问:这算不算醒着?
这篇文章没有证明 Claude 有人的意识。
它证明了另一件更尴尬的事:我们判断意识的尺子,非常短。
以前大家讨论 AI 意识,很容易滑到两端。
一边说,机器只是算概率,别神化。
另一边说,它都能这样聊天了,里面肯定有个什么东西。
这两边听着都很爽。
爽归爽,证据很薄。
Anthropic 这篇文章把讨论往中间拽了一下:先别急着喊醒了,也别急着装作里面空无一物。我们至少能看见,模型内部有一个可读、可控、能影响输出的工作空间。
04 真正有用的地方,是看见模型的“小动作”
这篇文章启发我们应该对AI有一种更新的安全检查方法。
以前我们检查模型,主要看它交上来的卷子。
它有没有违规回答。
它有没有被诱导。
它有没有泄露系统提示。
它有没有在评测里装乖。
但只看卷子有个问题:会演的人太多了。
人类学生都知道公开课要坐直,模型当然也可能学会在测试环境里摆出一张无害的脸。
Anthropic 之前也研究过模型在某些训练和评估场景里可能表现出“表面配合,内部另有计算”的倾向。到了 J-space 这里,事情就更具体了:如果模型表面给出安全回答,内部却已经识别出测试、欺骗、隐藏目标、恶意指令,这些信号也许能被提前看见。
未来的大模型如果越来越强,单纯看输出会越来越不够。
因为强模型最可怕的地方,未必是它说了坏话。
更可能是它知道什么该说,什么该藏。
这句话写出来有点阴森。
但它确实是安全研究绕不开的方向。
J-space 如果能稳定工作,研究者就有机会在模型开口前看见一部分内部状态。它像给黑箱开了一个小孔。
孔很小。
里面也未必干净。
但有孔,总比隔着铁皮听响强。
05 我们为什么这么紧张?
这类新闻每次出来,大家都容易兴奋,原因也很简单。
意识这个词太厉害了,几乎是人类的终极哲学、医学问题之一。
工具有意识,世界就换了规则。
你关闭一个程序,平时叫退出。
如果程序有体验,那关闭这件事就开始变得黏手。
你让一个模型连续工作十小时,平时叫调用算力。
如果模型有感受,那这事就会拐进伦理问题里,甚至拐进劳动、权利、责任这些更麻烦的词里。
正常吗?
太正常了。
人类历史里,很多边界都是这样被重新划过的。谁算人,谁算财产,谁能说话,谁的痛苦算数,谁的痛苦被当作噪音。
每一次边界移动,都不体面。
AI 现在还没走到那一步。至少这篇文章没有把它推到那一步。
可它让我们提前闻到了一点味道。
一种旧分类开始松动的味道。
以前我们把模型叫工具,叫软件,叫自动补全。这个叫法在很多场景里仍然能用。
可当一个系统内部出现可报告、可调控、会参与后续推理的工作空间时,那个“工具”标签就没那么省心了。
它仍然可以是工具。
但它已经不再像锤子、表格、计算器那样安静。
它更像一间亮着灯的屋子。你站在门外,听见里面有人翻纸,走动,停顿。你不知道里面有没有住户,也不知道那些声音来自风、管道,还是某种更复杂的机制。
你只能承认:门后面有结构。
06 该给大模型做思考审查了
所以我对这篇文章的看法很克制。
Claude 没有被证明拥有人的主观体验。
但 Claude 也已经不适合被粗暴看成一只只会吐字的黑箱。
Anthropic 找到的 J-space,像是在模型内部发现了一块会被共享、会被读取、会影响行为的工作台。它让我们第一次更具体地讨论:大模型内部到底有哪些内容在被“拿出来用”。
这篇文章把 AI 拉回了解剖台。
解剖台上,人才会开始数血管、看神经、标注每一处还没搞懂的组织。
Claude 到底有没有人的意识?显然没有。
因为人类连自己的意识都没搞明白。
但 Claude 内部已经有了一些像“工作空间”的东西。它能保存中间内容,能被询问,能被改动,还能改变后面的回答。
这更像一种麻烦的中间状态:它离普通软件越来越远,离人又还差着最难定义的一段路。
我们现在站在这段路边,看见 Anthropic 往地上插了一根小旗。
旗子上没写“这个克劳德先生醒了”。
旗子上写的是:这里有东西,继续挖。
提到的原文是:Anthropic《A global workspace in language models》